

در بسیاری از تیمهای محتوا، «سرعت انتشار» تبدیل به معیار موفقیت شده است: هرچه بیشتر، بهتر. اما چند هفته بعد، گزارشها چیز دیگری میگویند؛ نرخ پرش بالا میرود، زمان ماندن کاهش پیدا میکند، صفحهها رتبه نمیگیرند یا بدتر از آن، به خاطر خطاهای factual و تناقضهای داخلی، اعتبار برند آسیب میبیند. مشکل معمولاً این نیست که محتوا «کم» بوده؛ مشکل این است که قبل از انتشار، هیچ دروازه کنترل کیفیتی وجود نداشته که بگوید این متن واقعاً آماده انتشار هست یا نه.
هوش مصنوعی میتواند در همین نقطه مفید باشد: نه به عنوان داور مطلق، بلکه به عنوان یک ابزار امتیازدهی و هشداردهی برای سنجش کیفیت. اگر شاخصها درست تعریف شوند، میتوان قبل از انتشار، ریسک افت کیفیت را پایین آورد و یک روند پایدار برای بهبود ساخت.
ابعاد کیفیت محتوا: چه چیزی را دقیقاً «کیفیت» میدانیم؟
برای ساخت یک مدل ارزیابی کیفیت محتوا با هوش مصنوعی، اول باید کیفیت را به چند بُعد قابل بررسی بشکنیم. در تجربه تیمهای ایرانی، افت کیفیت معمولاً از یک بُعد مشخص نمیآید؛ ترکیبی از «درستی»، «پوشش نیت جستجو»، «تازگی»، «انسجام»، «خوانایی» و «تمایز» است. اگر این ابعاد را جداگانه اندازهگیری کنید، هم اصلاح سادهتر میشود، هم تصمیمگیری (قبول/رد) شفافتر.
- درستی (Accuracy): ادعاها، اعداد، تعاریف و نسبتدادنها باید دقیق و قابل اتکا باشند؛ مخصوصاً در حوزههایی مثل UX/SEO که اصطلاحات، حساس و قابل سوءبرداشتاند.
- پوشش نیت (Intent Coverage): آیا کاربر بعد از خواندن متن واقعاً به هدفش میرسد؟ یا فقط یک معرفی کلی دریافت میکند؟
- تازگی (Freshness): محتوا با واقعیت امروز (ابزارها، روندها، استانداردها) همخوان است یا به نسخههای قدیمی تکیه دارد؟
- انسجام (Coherence): ساختار منطقی، نبود تناقض، و اتصال درست پاراگرافها و تیترها.
- خوانایی (Readability): متن برای مخاطب ایرانی اسکنپذیر است؟ جملهها بیش از حد بلند نیستند؟ تعریفها ساده و دقیقاند؟
- تمایز (Differentiation): متن چیزی اضافه میکند یا نسخه بازنویسیشده همان حرفهای تکراری وب است؟
این شش بُعد، یک زبان مشترک بین نویسنده، ویراستار، مدیر محتوا و حتی کارفرما ایجاد میکند. مرحله بعد این است که هر بُعد را به شاخصهای قابل اندازهگیری تبدیل کنیم تا AI و انسان بتوانند با یک معیار مشترک صحبت کنند.
شاخصهای قابل اندازهگیری برای هر بُعد (قابل امتیازدهی با AI)
اگر شاخصها مبهم باشند، خروجی AI هم مبهم میشود. هدف این بخش طراحی معیارهایی است که هم قابل امتیازدهی باشند، هم قابل اقدام. پیشنهاد عملی این است که برای هر بُعد، چند شاخص با امتیاز ۰ تا ۵ تعریف کنید و در نهایت نمره ۱۰۰ بسازید. نمونه شاخصهای پیشنهادی:
۱) درستی
- Fact-check coverage: چند ادعای مهم متن قابل ارجاع به منبع معتبر است؟ (AI ادعاها را استخراج میکند، انسان تأیید نهایی را انجام میدهد.)
- Terminology correctness: استفاده درست از اصطلاحات (مثلاً تفاوت UX و UI، یا Intent و Keyword).
۲) پوشش نیت
- Query-to-outline match: تطابق تیترها با پرسشهای محتمل کاربر.
- Task completion: آیا کاربر بعد از خواندن میتواند اقدام کند؟ (مثلاً یک چکلیست، معیار تصمیم، یا فرایند گامبهگام دارد.)
۳) تازگی
- Version sensitivity: آیا متن به «اصل» اشاره میکند یا به «نسخه»؟ هرجا وابسته به ابزار است، تاریخدار و قابل بازبینی باشد.
- Update signals: وجود نشانههای بهروزرسانی مثل اشاره به تغییرات اخیر استانداردها یا رفتار موتورهای جستجو (بدون ادعاهای بدون منبع).
۴) انسجام
- Logical flow: آیا هر بخش، مقدمه بخش بعدی است یا پرش موضوعی داریم؟
- Contradiction scan: AI موارد تناقض احتمالی را استخراج کند (مثلاً یکجا «کمیت مهم نیست» و جای دیگر «روزانه ۳ مطلب لازم است»).
۵) خوانایی
- Sentence length & density: میانگین طول جمله، تعداد بندهای وابسته، و تراکم اصطلاحات تخصصی.
- Scanability: وجود تیترهای کاربردی، لیستها، و پاراگرافهای کوتاه.
۶) تمایز
- Originality cues: وجود مدل، جدول، چارچوب، یا مثال واقعی (نه صرفاً تعریف).
- Specificity: تعداد بخشهایی که «چگونه» را توضیح میدهند، نه فقط «چیست».
نکته کلیدی این است که AI را مجبور کنید «شواهد» بدهد: کدام جمله مشکل دارد؟ کدام بخش مبهم است؟ کجا نیاز به مثال دارد؟ امتیاز بدون دلیل، در عمل کمکی به کنترل کیفیت نمیکند.
وزندهی شاخصها بر اساس نوع صفحه (مقاله، لندینگ، خدمات)
همه صفحهها یک هدف ندارند؛ پس وزندهی باید با نوع صفحه تغییر کند. مثلاً در صفحه خدمات، تمایز و انسجام پیام برند مهمتر از «تازگی» به معنای روندهای روز است. در مقاله تحلیلی، تازگی و درستی برجستهتر میشود. یک ماتریس وزندهی ساده (جمع = ۱۰۰) تصمیمگیری را استاندارد میکند:
| نوع صفحه | درستی | پوشش نیت | تازگی | انسجام | خوانایی | تمایز |
|---|---|---|---|---|---|---|
| مقاله آموزشی/تحلیلی | ۲۰ | ۲۰ | ۱۵ | ۱۵ | ۱۵ | ۱۵ |
| صفحه خدمات | ۱۵ | ۲۵ | ۵ | ۲۰ | ۲۰ | ۱۵ |
| لندینگ کمپین | ۱۰ | ۳۰ | ۵ | ۲۰ | ۲۵ | ۱۰ |
برای مثال، وقتی درباره استراتژی محتوا و سئوی پیشرفته صفحهسازی میکنید، پوشش نیت و خوانایی باید به تصمیمگیری مخاطب کمک کند؛ اما درستی تعریفها هم حیاتی است تا اعتماد ایجاد شود. در مقابل، در طراحی وبسایت شرکتی، انسجام پیام و ساختار محتوا (ارتباط ارزش پیشنهادی با نیاز مخاطب) معمولاً وزن بالاتری دارد.
چگونه از هوش مصنوعی برای امتیازدهی استفاده کنیم، بدون اتکای کورکورانه؟
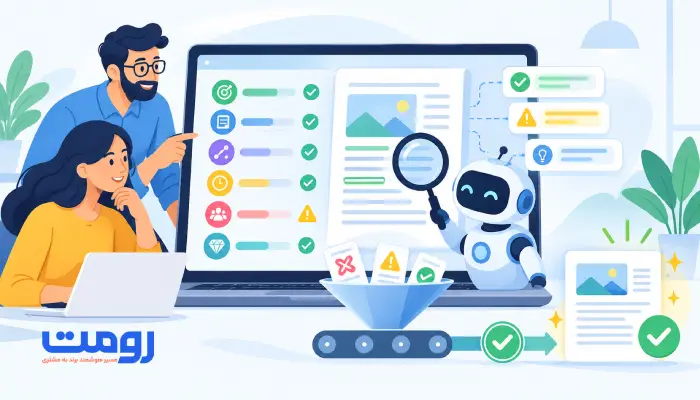
AI در ارزیابی کیفیت، دو نقش مفید دارد: «استخراج» و «نقد ساختاری». نقش خطرناک آن «قضاوت نهایی بدون توضیح» است. برای جلوگیری از اتکای کورکورانه، فرایند را به چند گام تقسیم کنید:
- استخراج ادعاها و نقاط حساس: از AI بخواهید فهرست ادعاهای قابل مناقشه، اعداد، توصیههای عملی و اصطلاحات تخصصی را استخراج کند.
- امتیازدهی مشروط به شاهد: هر امتیاز باید همراه با نقل بخش مربوطه و دلیل باشد (مثلاً «این پاراگراف نیت کاربر را پوشش نمیدهد چون…»).
- پیشنهاد اصلاح حداقلی: به جای بازنویسی کامل، AI باید «کمترین تغییر لازم» را پیشنهاد دهد: کوتاهسازی جمله، افزودن مثال، جابهجایی تیترها، یا حذف تکرار.
- تقاطع با داده واقعی: اگر صفحه قبلاً نسخهای داشته، دادههایی مثل CTR، اسکرول، و سرچ داخلی سایت میتواند به AI داده شود تا نقدش از حالت ذهنی خارج شود.
چالش رایج در تیمهای ایرانی این است که AI «لحن» را یکدست میکند و تمایز را کاهش میدهد. راهحل: تمایز را به شاخص تبدیل کنید و از AI بخواهید به طور مشخص بگوید کدام بخشها شبیه محتوای عمومی وب هستند و کجا باید یک مدل، مثال یا معیار عددی اضافه شود.
اگر AI نتواند نشان دهد دقیقاً کدام جمله مسئله دارد، امتیازش نباید مبنای تصمیم انتشار باشد.
دروازه کنترل کیفیت (قبول/مشروط/رد) با آستانههای مشخص
وقتی شاخصها و وزنها مشخص شد، نوبت به یک «گیت انتشار» میرسد تا تصمیمها سلیقهای نباشند. پیشنهاد عملی: نمره نهایی از ۱۰۰ + دو شرط حداقلی برای جلوگیری از انتشار محتوای پرریسک.
آستانهها
- قبول (Publish): نمره کل ۸۰ به بالا، و هیچ بُعدی کمتر از ۳ از ۵ نباشد.
- مشروط (Revise & Publish): نمره کل ۶۵ تا ۷۹، یا یک بُعد بین ۲ تا ۳ باشد.
- رد (Hold): نمره کل کمتر از ۶۵، یا «درستی» کمتر از ۳ از ۵ باشد (حتی اگر نمره کل بالاتر باشد).
در هر حالت چه اصلاحاتی لازم است؟
- قبول: فقط ویرایش نهایی نگارشی، یکبار چک لینکهای داخلی و یک مرور انسانی کوتاه برای لحن.
- مشروط: اصلاح هدفمند همان بُعد ضعیف. مثال: اگر پوشش نیت پایین است، تیترها را بر اساس پرسشهای کاربر بازطراحی کنید؛ اگر تمایز پایین است، یک چارچوب یا جدول تصمیم اضافه کنید.
- رد: بازتعریف هدف صفحه و outline. معمولاً متن از ابتدا بر نیت درست ساخته نشده یا دچار تناقض و ادعاهای بدون پشتوانه است؛ ویرایش جزئی کافی نیست.
مزیت این دروازه در سازمانهای کوچک این است که به جای «بحث طولانی روی سلیقه»، اختلافها را به «شاخص» تبدیل میکند. تصمیم انتشار، تبدیل به تصمیم ریسک میشود.
چکلیست انسانی ۵ موردی قبل از انتشار (چیزی که AI معمولاً جا میاندازد)
حتی بهترین مدل ارزیابی کیفیت محتوا با هوش مصنوعی، جای مرور انسانی را نمیگیرد؛ بهخصوص برای ظرافتهای اعتماد، فرهنگ و تجربه واقعی کاربر ایرانی. این پنج مورد را به عنوان آخرین مرحله نگه دارید:
- یکپارچگی پیام برند: آیا متن با لحن و وعده برند سازگار است یا شبیه یک متن عمومی و بیصداست؟
- واقعگرایی در مثالها: مثالها با فضای ایران همخواناند؟ (مثلاً محدودیتهای پرداخت، رفتار کاربران موبایلی، یا حساسیت به اعتماد.)
- شفافیت «گام بعدی»: کاربر بعد از خواندن دقیقاً چه کاری باید بکند؟ اگر صفحه خدمات است، مسیر تصمیمگیری روشن است؟
- ریسک حقوقی و ادعایی: ادعاهای مطلق، مقایسههای بیمنبع، و وعدههای غیرقابل اثبات حذف یا دقیقسازی شدهاند؟
- کنترل تجربه خواندن روی موبایل: تیترها، لیستها و پاراگرافها واقعاً روی صفحه کوچک قابل اسکن هستند؟
حالتهای استثنا: خبر، راهنما و صفحات برنامهمحور چگونه ارزیابی میشوند؟
اگر یک مدل واحد را برای همه چیز اعمال کنید، یا کیفیت قربانی میشود یا سرعت. سه نوع صفحه معمولاً نیاز به تنظیم معیارها دارند:
۱) صفحات خبری
در خبر، تازگی و درستی وزن بیشتری دارند و تمایز معمولاً پایینتر است (چون خبر، گزارش واقعیت است نه چارچوبسازی). پیشنهاد: آستانه «قبول» را با شرط سختگیرانهتر برای درستی تنظیم کنید و برای تمایز، انتظار را کاهش دهید. همچنین، «برچسب زمان» و امکان بهروزرسانی بعدی مهم است.
۲) صفحات راهنما (How-to)
در راهنماها، پوشش نیت و خوانایی باید غالب باشد. اگر کاربر نتواند مراحل را اجرا کند، حتی متن کاملاً درست هم شکست میخورد. AI میتواند مراحل را از متن استخراج کند و بررسی کند آیا ترتیب منطقی دارند، پیشنیازها مشخصاند و ابهام عملیاتی وجود ندارد یا نه.
۳) صفحات برنامهمحور (Programmatic)
در صفحات تولیدشده بر اساس الگو (مثلاً صفحات شهرها/دستهبندیها)، ریسک اصلی «محتوای تکراری» و «کمعمق بودن» است. اینجا تمایز باید به شکل دیگری سنجیده شود: آیا حداقل یک بخش دادهمحور، یک نکته محلی، یا یک FAQ اختصاصی وجود دارد؟ همچنین، انسجام ساختاری مهمتر از نثر خلاقانه است.
جمعبندی: چرا این مدل، ریسک را کم و کیفیت را پایدار میکند؟
کنترل کیفیت قبل از انتشار، هزینه نیست؛ بیمه است. وقتی کیفیت را به ابعاد مشخص میشکنید، برای هر بُعد شاخص قابل اندازهگیری میسازید و وزنها را بر اساس نوع صفحه تنظیم میکنید، کیفیت از حالت «سلیقهای» خارج میشود. در این مسیر، استفاده از ابزارهای هوش مصنوعی و راهکارهای تخصصی مانند رومت میتواند به بهینهسازی فرایند ارزیابی و کنترل کیفیت محتوا کمک کند. هوش مصنوعی در این مدل نقش شتابدهنده دارد: ادعاها را استخراج میکند، تناقضها را هشدار میدهد و نقاط مبهم را برجسته میسازد؛ اما تصمیم نهایی با یک دروازه شفاف و یک چکلیست انسانی گرفته میشود. نتیجه عملی این رویکرد، کاهش انتشار محتوای پرریسک، بهبود تدریجی استاندارد تیم و ساختن آرشیوی است که بهجای افزایش حجم، به افزایش اعتماد و عملکرد منجر میشود.
پرسشهای متداول
آیا میتوان ارزیابی کیفیت محتوا را کامل به AI سپرد؟
بهتر است نه. AI در استخراج و نقد ساختاری عالی است، اما در تشخیص ریسک ادعاها، حساسیتهای برند، و تناسب فرهنگی با مخاطب ایرانی محدودیت دارد. راه درست این است که AI امتیاز و دلیل بدهد، اما انتشار از دروازه کنترل کیفیت و مرور انسانی عبور کند؛ مخصوصاً برای بُعد «درستی» و «ریسک ادعایی».
حداقل شاخصهایی که برای شروع لازم است چیست؟
اگر میخواهید ساده شروع کنید، این چهار مورد را بسنجید: درستی (ادعاهای قابل ارجاع)، پوشش نیت (وجود پاسخ عملی)، انسجام (نبود تناقض و پرش موضوعی)، و خوانایی (اسکنپذیری روی موبایل). بعد از تثبیت فرایند، تازگی و تمایز را دقیقتر کنید.
برای صفحه خدمات، کدام بُعد از همه مهمتر است؟
معمولاً پوشش نیت و انسجام. مخاطب صفحه خدمات میخواهد سریع بفهمد «این سرویس برای من هست یا نه»، چه خروجیای میگیرد و مسیر تصمیمگیری چیست. خوانایی هم مهم است چون اسکن سریع در موبایل رایج است. تازگی معمولاً وزن کمتری دارد مگر در سرویسهای وابسته به روندهای تکنولوژی.
اگر نمره کلی خوب باشد ولی درستی پایین باشد، چه کنیم؟
این حالت باید «رد» تلقی شود. محتوایی که خوانا و منسجم است اما ادعاهایش مشکل دارد، خطر اعتبار برند را بالا میبرد. راهحل عملی: ادعاهای اصلی را جدا کنید، برای هرکدام منبع معتبر پیدا کنید یا ادعا را محدود و دقیقسازی کنید، سپس دوباره امتیازدهی انجام دهید.
هر چند وقت یکبار باید وزندهیها و آستانهها را بازنگری کرد؟
هر زمان که نوع صفحهها، هدف کسبوکار یا رفتار کاربران تغییر کند. به طور عملی، بازنگری فصلی منطقی است. اگر دادههای واقعی مثل نرخ تبدیل یا CTR نشان دهد صفحههایی با نمره بالا هم عملکرد ندارند، یعنی وزنها با هدف صفحه همراستا نیستند و باید تنظیم شوند.