
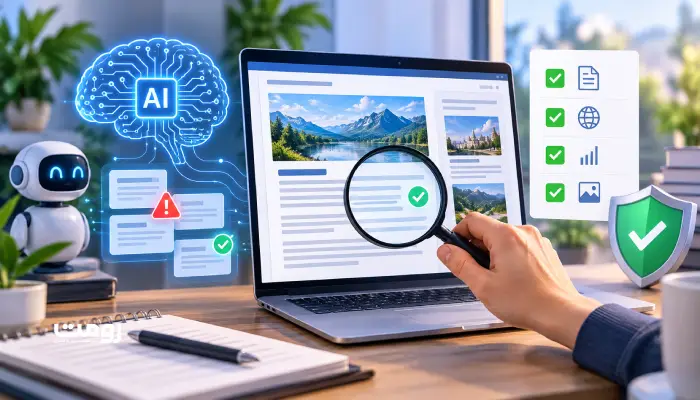

«طبق گزارش رسمی، ۷۳٪ کاربران ایرانی به سایتهایی که از هوش مصنوعی برای تولید محتوا استفاده میکنند اعتماد بیشتری دارند.» جمله از نظر لحن قاطع است، عدد دقیق دارد و حتی «گزارش رسمی» هم به آن چسبانده شده؛ اما اگر منبع، نام گزارش، سال انتشار و روش اندازهگیری مشخص نباشد، به احتمال زیاد یک ادعای ساختگی یا دستکاریشده است. همین جنس خطاها همانجایی خطرناک میشوند که محتوا قرار است تصمیمساز باشد: روی صفحه خدمات، در یک لندینگ، داخل پروپوزال یا حتی در یک مقاله که قرار است اعتماد ایجاد کند.
ریسک کسبوکاری توهم هوش مصنوعی فقط «اشتباه علمی» نیست. توهم میتواند باعث شکایت حقوقی بهخاطر انتساب غلط، کاهش نرخ تبدیل بهخاطر وعدههای نادرست، از دست رفتن اعتبار برند در شبکههای اجتماعی، یا تصمیمهای اشتباه در طراحی محصول و استراتژی محتوا شود. در بازار ایران که اعتماد دیجیتال شکنندهتر است و مخاطب نسبت به ادعاهای بزرگ حساسیت دارد، یک خطای کوچک میتواند هزینهای بزرگ بسازد. هدف این راهنما، ساخت یک روش عملی برای تشخیص و جلوگیری از توهم در محتوا و تعریف یک آستانه روشن «قبول/رد» برای انتشار است.
۱) توهم هوش مصنوعی در محتوا دقیقاً چیست و چرا شبیه حقیقت به نظر میرسد؟
توهم (Hallucination) در مدلهای زبانی یعنی تولید اطلاعاتی که از نظر ساختار زبانی و منطق ظاهری «قانعکننده» است، اما پشتوانه قابلاعتماد ندارد یا با واقعیت ناسازگار است. این اتفاق الزماً از «بدنیت» نمیآید؛ مدل تلاش میکند پاسخ کامل بدهد و در جاهایی که داده یا قطعیت کافی ندارد، با الگوهای محتمل، متن را کامل میکند.
در تولید محتوای وب، خطر زمانی بیشتر میشود که خروجیِ هوش مصنوعی بهجای «پیشنویس» بهعنوان «حقیقت آماده انتشار» تلقی شود. بهخصوص در حوزههایی مثل UX، سئو، قوانین، پزشکی و امور مالی که هر جزئیات میتواند اثر مستقیم روی تصمیم مخاطب بگذارد.
برای مدیریت این ریسک، بهتر است خروجی AI را از ابتدا در یکی از این سه دسته قرار دهید:
- متن کمریسک (توضیح مفهومی، مثالسازی، بازنویسی): غالباً قابل استفاده با ویرایش انسانی
- متن میانریسک (توصیههای فنی، فرآیندها، چکلیستها): نیازمند تطبیق با تجربه و استانداردهای معتبر
- متن پرریسک (آمار، نقل قول، قوانین، انتساب به افراد/برندها، ادعای رتبه/گواهی/نتیجه): فقط با صحتسنجی سختگیرانه
اگر تیم شما روی استراتژی محتوا و سئوی پیشرفته کار میکند، این تفکیک ریسک باید به فرایند تولید و انتشار گره بخورد؛ چون محتوا در نهایت روی اعتماد، نرخ تبدیل و برداشت از برند اثر میگذارد.
۲) چهار نوع رایج توهم: عددی، تعریفی، انتسابی، استنتاجی
توهم فقط «عدد اشتباه» نیست. در عمل، چهار الگوی پرتکرار دارد که تشخیصشان کمک میکند سریعتر سراغ صحتسنجی هدفمند بروید.
توهم عددی (Numerical)
مدل عددهای دقیق و جذاب تولید میکند: درصدها، میانگینها، رتبهها، نرخ رشد، یا هزینهها. مشکل اینجاست که عددِ دقیق حس اعتبار میدهد، اما ممکن است هیچ دادهای پشت آن نباشد یا مربوط به کشوری/سال دیگری باشد.
توهم تعریفی (Definitional)
یک مفهوم را با تعریف ظاهراً درست اما نادقیق توضیح میدهد؛ مثلاً تفاوت «معماری اطلاعات» و «معماری محتوا» را طوری بیان میکند که با ادبیات تخصصی یا استانداردهای رایج سازگار نیست. این نوع توهم بهخصوص در محتوای آموزشی، آرام و بیسروصدا تخریب میکند.
توهم انتسابی (Attribution)
جملهای را به یک فرد، شرکت یا «گزارش معتبر» نسبت میدهد؛ یا لینکی میسازد که وجود ندارد. در بازار ایران، این نوع خطا میتواند به بحران اعتماد یا حتی تبعات حقوقی برسد.
توهم استنتاجی (Inferential)
از چند گزاره درست، یک نتیجه قطعی و تجویزی میسازد؛ مثلاً از یک مشاهده درباره رفتار کاربران، نسخه واحد برای همه کسبوکارها میدهد. این نوع توهم بیشتر در توصیههای UX/SEO رخ میدهد و باعث تصمیمهای غلط طراحی میشود.
۳) کجاها توهم بیشتر رخ میدهد؟ سه نقطه پرخطر: آمار، نقل قول، جزئیات فنی
برای کنترل توهم، لازم نیست همه متن را به یک اندازه سختگیرانه بررسی کنید. کافی است نقاط پرخطر را بشناسید و انرژی تیم را همانجا متمرکز کنید.
- آمار و اعداد: درصدها، «میانگین بازار»، «طبق پژوهش»، «افزایش X درصدی». هرجا عدد هست، باید روش و منبع هم باشد.
- نقل قول و انتساب: جمله داخل گیومه، نام افراد شناختهشده، «طبق گفته گوگل»، «طبق استاندارد ISO». اگر نقل قول دقیق نیست یا رفرنس ندارد، باید حذف یا بازنویسی شود.
- جزئیات فنی: تنظیمات ابزارها، نام پارامترها، نسخهها، دستورات، یا ادعاهای «بهترین روش». در حوزه وب، یک تغییر نسخه میتواند توصیه را کاملاً غلط کند.
در پروژههایی مثل طراحی وبسایت شرکتی، همین سه نقطه پرخطر معمولاً وارد صفحه خدمات، صفحه درباره ما، و مطالعات موردی میشوند؛ یعنی همان جاهایی که بیشترین اثر را بر اعتماد و تصمیم خرید دارند.
۴) قواعد نگارشی برای کاهش ریسک توهم (قبل از صحتسنجی)
بخشی از توهم با «سبک نوشتن» تشدید میشود. اگر قواعد نگارشی را طوری تنظیم کنید که متن به سمت قطعیتهای ساختگی نرود، حجم خطا و زمان بررسی پایین میآید.
قواعد پیشنهادی:
- عدد بدون منبع ممنوع: اگر عدد لازم است، منبع/سال/دامنه را هم بیاورید؛ اگر نه، عدد را کیفی کنید (مثلاً «در بسیاری از پروژهها»).
- قطعیت را درجهبندی کنید: بهجای «حتماً»، «همیشه»، «بهترین»، از «در اغلب موارد»، «معمولاً»، «بسته به زمینه» استفاده کنید؛ مگر اینکه سند معتبر دارید.
- یک ادعا در هر جمله: ترکیب چند ادعا در یک جمله، هم توهم را پنهان میکند هم صحتسنجی را سخت.
- تمایز مشاهده از توصیه: «مشاهده: X» را جدا از «توصیه: Y» بنویسید تا استنتاجهای بیپشتوانه کمتر شود.
- منبعگذاری در لحظه نوشتن: بهجای اینکه آخر کار دنبال منبع بگردید، همان لحظه کنار ادعای پرریسک علامت بزنید (مثلاً [نیازمند منبع]).
۵) فرآیند صحتسنجی چندمرحلهای: از تریاژ تا ثبت تغییرات
صحتسنجی اگر فقط «یک بار چک کردن» باشد، در عمل شکست میخورد؛ چون توهمها پراکندهاند و بخشی از خطاها بعداً هنگام بازنویسی وارد میشوند. یک فرآیند چندمرحلهای، قابل تکرار و قابل آموزش لازم است.
- مرحله تریاژ (برچسب ریسک): متن را خط به خط اسکن کنید و هر ادعا را در یکی از سه سطح کم/میان/پرریسک علامت بزنید. ادعاهای پرریسک: عدد، نقل قول، انتساب، مقایسه قطعی، دستورالعمل فنی.
- مرحله جداسازی ادعا (Claim extraction): ادعاهای ترکیبی را به چند ادعای کوچک تقسیم کنید. هدف این است که هر ادعا «قابل تست» شود.
- مرحله بررسی منبع: برای ادعاهای پرریسک فقط به منابع واقعی و قابل ردیابی تکیه کنید: سند رسمی، مقاله پژوهشی، مستندات محصول/ابزار. اگر منبع پیدا نشد، ادعا یا حذف شود یا به «فرض/تجربه» تبدیل شود.
- مرحله تطبیق با زمینه ایران: اگر داده یا توصیه مربوط به بازار جهانی است، دامنه آن را مشخص کنید (مثلاً «در بسیاری از بازارها»). از تعمیم مستقیم به «کاربران ایرانی» بدون داده معتبر پرهیز کنید.
- مرحله بازنویسی ایمن: ادعاهای حساس را با ساختارهای کمریسک بازنویسی کنید: افزودن شرط، ذکر محدودیت، مشخصکردن دامنه، یا تبدیل به توصیه گزینهای.
- مرحله ثبت تغییرات: یک لاگ ساده نگه دارید: «ادعای اولیه»، «مشکل»، «اقدام» (حذف/اصلاح/منبعگذاری)، «لینک/سند». این کار جلوی برگشت خطا در ویرایشهای بعدی را میگیرد.
۶) چکلیست ۶ موردی بررسی ادعاها + آستانه قبول/رد
این چکلیست را میتوان برای هر پاراگراف یا هر بخش حساس اجرا کرد. خروجی باید یکی از دو حالت باشد: «قابل انتشار» یا «نیازمند اصلاح/حذف». برای تیمهای کوچک، همین چارچوب جلوی بیشترین خطاها را میگیرد.
| مورد | سوال کنترل | اقدام اگر پاسخ «نه» است |
|---|---|---|
| ۱) منبعپذیری | میتوانم منبع دقیق، قابل دسترسی و مرتبط معرفی کنم؟ | حذف ادعا یا تبدیل به بیان تجربی/شرطی |
| ۲) قابلیت راستیآزمایی | آیا ادعا به یک گزاره مشخص و تستپذیر تبدیل شده؟ | تقسیم ادعا به چند جمله و سادهسازی |
| ۳) دقت عدد/دامنه | اگر عدد دارد، سال، جامعه آماری و دامنه مشخص است؟ | حذف عدد یا افزودن مشخصات و منبع |
| ۴) انتساب درست | نقل قول/انتساب دقیقاً مطابق منبع اصلی است؟ | حذف گیومه/انتساب یا جایگزینی با پارافریز بدون نسبتدادن |
| ۵) سازگاری فنی | جزئیات فنی با مستندات رسمی و نسخههای رایج سازگار است؟ | ارجاع به مستندات، یا تبدیل به توصیه عمومی و مشروط |
| ۶) تناسب با زمینه ایران | آیا ادعا بدون داده معتبر به کاربران ایرانی تعمیم داده نشده؟ | مشخصکردن دامنه («در برخی بازارها») یا حذف تعمیم |
آستانه قبول/رد پیشنهادی:
- قبول: برای ادعاهای پرریسک، حداقل ۵ از ۶ مورد «بله» باشد و مورد ۱ (منبعپذیری) و ۴ (انتساب) حتماً «بله» باشند.
- رد/اصلاح اجباری: اگر حتی یکی از موارد ۱ یا ۴ «نه» باشد، ادعا نباید با همان شکل منتشر شود.
۷) خطاهای رایج در کنترل توهم + جمعبندی راهبردی
حتی تیمهای حرفهای هم در کنترل توهم به چند دام تکراری میافتند:
- اعتماد به لحن مطمئن: مدلها در بیانِ غلط هم میتوانند بسیار روان و قطعی بنویسند. معیار باید «قابلیت ردیابی» باشد، نه «اعتماد به نفس متن».
- تکیه بر منابع نامشخص: عباراتی مثل «طبق یک تحقیق» یا «گزارشها نشان میدهد» اگر به سند مشخص وصل نشود، عملاً پوشش زبانی برای توهم است.
- ترکیب چند ادعا در یک جمله: وقتی یک جمله هم عدد دارد، هم علتومعلول میسازد، هم توصیه میکند، احتمال خطا چند برابر میشود و بررسی را کند میکند.
در نهایت، جلوگیری از توهم بیشتر از آنکه «یک ترفند» باشد، یک فرهنگ کاری است: فرهنگ دقت، فروتنی علمی و ثبت تغییرات. تیمی که ادعاها را کوچک و تستپذیر مینویسد، منابع را همانجا متصل میکند و یک لاگ شفاف از اصلاحات نگه میدارد، هم سریعتر تولید میکند و هم ریسک برند را پایین میآورد. در رویکردهایی مانند آنچه رومت در طراحی و اجرای استراتژیهای محتوایی دنبال میکند، صحتسنجی خروجی AI باید بخشی از استاندارد کیفیت محتوا باشد، نه مرحلهای فرعی در انتهای کار. اگر خروجی AI قرار است در صفحات کلیدی سایت وارد شود، بهتر است این فرآیند حتی به معماری تصمیمگیری دیجیتال نیز متصل شود؛ چون اعتماد، دارایی اصلی حضور آنلاین است.
پرسشهای متداول
آیا توهم هوش مصنوعی فقط در آمار و اعداد رخ میدهد؟
خیر. آمار فقط آشکارترین شکل آن است. توهم میتواند در تعریف مفاهیم (مثلاً تعریف نادقیق یک اصطلاح UX)، در انتساب نقل قول به افراد/برندها، و در نتیجهگیریهای قطعی از چند مشاهده رخ دهد. برای همین باید ادعاها را بر اساس نوعشان دستهبندی کنید و برای هر نوع، روش بررسی مناسب داشته باشید.
اگر منبع پیدا نشود، بهتر است ادعا را حذف کنم یا بازنویسی؟
برای ادعاهای پرریسک، اگر منبع قابل ردیابی ندارید، بهترین گزینه حذف یا تبدیل به بیان مشروط/تجربی است. مثلاً بهجای «X درصد افزایش»، میتوانید بگویید «در برخی پروژهها بهبود قابل توجه دیده میشود، اما به زمینه وابسته است». این بازنویسی باید شفاف باشد و وانمود به قطعیت نکند.
چطور میتوانم ادعاهای ترکیبی را سریع تشخیص بدهم؟
به دنبال جملههایی باشید که همزمان «عدد + علتومعلول + توصیه» دارند یا چند گزاره را با «بنابراین/پس» به هم وصل میکنند. یک روش ساده این است که جمله را به چند سوال بشکنید: «چه چیزی؟ بر اساس چه دادهای؟ در چه دامنهای؟ نتیجه دقیقاً چیست؟» اگر پاسخها جداگانهاند، ادعاها را هم جدا کنید.
آیا میشود به خروجی AI اعتماد کرد اگر چند بار همان پاسخ را تکرار کند؟
تکرار یک پاسخ لزوماً نشانه صحت نیست؛ چون مدل ممکن است الگوی زبانی مشابه تولید کند. معیار درست این است که ادعا به منبع معتبر وصل شود یا با مستندات رسمی/دادههای قابل بررسی تطبیق داده شود. برای ادعاهای حساس، «تکرارپذیری» بدون «منبعپذیری» کافی نیست.
حداقل استاندارد برای انتشار محتوای AI در سایت چیست؟
حداقل استاندارد این است که ادعاهای پرریسک (آمار، نقل قول، انتساب، جزئیات فنی) از چکلیست عبور کنند و آستانه قبول/رد رعایت شود. همچنین بهتر است یک ثبت تغییرات ساده داشته باشید تا اگر بعداً دادهها تغییر کرد یا خطایی دیده شد، مسیر اصلاح روشن باشد. این رویکرد کیفیت را پایدار میکند.